
Искусственный интеллект уже перестал быть просто инструментом, который умеет писать текст, генерировать изображения или подсказывать разработчику несколько строк кода. Следующий этап — AI-агенты, автономные системы, AI-driven-команды и перестройка самого процесса разработки программных продуктов.
Именно этим темам была посвящена Yandex Deep Tech Night, куда был приглашён руководитель учебного центра «ТЕРАКОР», технический директор и практикующий full-stack-разработчик Сергей Валерьевич Герасименко.
Для нас это часть работы
Участие в подобных мероприятиях — не формальная поездка на конференцию и не просто возможность послушать интересные доклады. Это часть работы.
Чтобы обучать современным технологиям, недостаточно однажды составить программу курса и несколько лет читать её без изменений. IT меняется слишком быстро. Инструменты, которые ещё вчера воспринимались как экспериментальные, сегодня становятся частью промышленной разработки.
Изучить → проверить в разработке → понять ограничения → применить → и только после этого обучать.
AI — это уже не просто нейросеть
Одна из важнейших идей Yandex Deep Tech Night прозвучала практически во всех выступлениях: хорошая языковая модель ещё не делает хороший AI-продукт.
Между эффектной демонстрацией нейросети и системой, которой можно доверить реальную работу, существует огромная инженерная дистанция. Можно подключить LLM к приложению за несколько часов. Но дальше возникают значительно более сложные вопросы.
Инженерные вопросы вокруг модели
- Какой контекст получит модель?
- Какими инструментами она сможет пользоваться?
- Какие данные ей разрешено читать?
- Что она сможет изменить самостоятельно?
- Какие действия потребуют подтверждения человека?
- Что произойдёт, если модель ошибётся?
- Как восстановить последовательность её действий?
- Как остановить агента, если он пошёл по неправильному пути?
Именно здесь AI из интересной технологии превращается в полноценную инженерную дисциплину. Модель становится только одним из компонентов большой системы, где появляются контекст, память, инструменты, управление правами, оркестрация, журналирование, контроль качества и безопасность.
От «умного помощника» к автономным системам
Эту мысль хорошо развил Мо Гавдат, бывший Chief Business Officer Google X.
Современную AI-систему нельзя оценивать исключительно по интеллекту самой модели. Намного важнее то, какую степень самостоятельности ей разрешает архитектура продукта. Автономность можно представить как лестницу.
Лестница автономности
- Сначала AI просто создаёт черновик.
- Затем предлагает рекомендацию.
- На следующем уровне система уже способна подготовить действие, но ждёт подтверждения человека.
- И только затем можно говорить о самостоятельной работе AI внутри заранее определённых границ.
Это принципиальный момент. Будущее AI заключается не в том, чтобы бесконтрольно передавать машине всё больше решений. Наоборот — чем больше возможностей получает система, тем лучше должны быть продуманы её ограничения, проверки и механизмы контроля.
Самая необычная часть: весь зал превратился в команду разработки
Особенно интересным для нас оказался доклад Александра Куваева, руководителя разработки клиентского продукта в Городских сервисах Яндекса.
Вместо классического формата, когда спикер показывает десятки слайдов, аудитория фактически стала участником большой инженерной игры. Весь зал превратился в одну AI-driven-команду. Нам предлагалось принимать решения: на каком этапе разработки внедрять искусственный интеллект и какой эффект это даст всему процессу.
- Бизнес-заказ
- Аналитика
- Проектирование
- Разработка
- Code Review
- Тестирование
- Релиз
- Эксплуатация
- Поддержка
AI можно попытаться внедрить практически в каждый из этих этапов. Но здесь обнаруживается важная вещь.
Ускорить программиста недостаточно
Представим, что AI-инструмент позволил разработчику писать код в два раза быстрее. Кажется, что производительность команды должна резко увеличиться. Но что произойдёт дальше?
Кода станет больше. Он быстрее попадёт на Code Review. Затем увеличится поток задач для тестирования. После этого возрастёт нагрузка на релизный процесс. То есть узкое место просто переместится дальше по цепочке.
Разработчик ускорился, а Time to Market всего продукта почти не изменился.
Именно поэтому внедрение AI нельзя измерять количеством сгенерированных строк кода или числом используемых сотрудниками AI-инструментов. Во время игры оценивались гораздо более важные показатели: предсказуемость разработки, скорость выхода изменений, качество продукта и объём ресурсов, который команда может направить на развитие вместо исправления ошибок и переделок.
Для «ТЕРАКОР» это особенно близкий подход. Мы давно рассматриваем разработку не как процесс «написать код по техническому заданию», а как полный жизненный цикл программного продукта. И AI только усиливает необходимость такого мышления.
AI-driven-разработка — это не установка ещё одного приложения
Сегодня легко создать впечатление внедрения искусственного интеллекта. Достаточно купить подписку на AI-ассистента и сказать: «Теперь наша команда использует AI». Но настоящая AI-driven-разработка начинается значительно глубже.
Нужно анализировать весь SDLC — Software Development Life Cycle — и понимать, где именно искусственный интеллект способен дать измеримый результат.
Где AI даёт результат
- Где он действительно ускоряет работу?
- Где снижает количество ошибок?
- Где помогает разработчику?
- А где, наоборот, создаёт дополнительный слой проверки и новые риски?
AI должен оптимизировать не отдельного разработчика, а весь поток создания программного продукта.
Модель — это двигатель. Агент — вся машина
Логичным продолжением этой темы стало выступление Андрея Шалунова из Персональных сервисов Яндекса.
Когда говорят об AI-агентах, иногда создаётся впечатление, будто речь идёт о какой-то отдельной новой магической технологии. На практике всё значительно интереснее — и значительно инженернее.
Можно провести простую аналогию: нейросетевая модель — это двигатель, AI-агент — это автомобиль целиком. Одного мощного двигателя недостаточно. Нужна система управления, тормоза, датчики, правила движения. Нужно понимать, кто находится за рулём и в какой момент управление должно перейти человеку.
Работа агента строится примерно по следующему циклу:
Вокруг этого появляются права доступа, схема данных, память, подтверждение действий человеком, повторные попытки, ограничения, механизм остановки, журнал выполненных действий и наблюдаемость. Для full-stack-разработчика это становится новым полноценным слоем архитектуры.
Одного prompt engineering уже мало
Несколько лет назад большая часть разговоров вокруг генеративного AI была связана с промптами: как правильно сформулировать запрос, как заставить модель отвечать точнее, как написать хороший system prompt. Сегодня этого уже недостаточно.
На первый план выходит context engineering. Разработчик должен проектировать не только текст инструкции для модели, но и всю среду, в которой она работает.
Context engineering
- Какие данные попадут в контекст?
- Откуда они будут получены?
- Как определить их актуальность?
- Что сохранить в памяти?
- Что удалить?
- Какие инструменты предоставить модели?
- Какие действия разрешить автоматически?
- Какие потребуют подтверждения?
Это уже гораздо ближе к классической архитектуре программных систем, чем к простому «общению с нейросетью».
Своя модель или чужая?
Отдельный пласт конференции был посвящён развитию собственных моделей. На первый взгляд кажется очевидным: зачем создавать собственную модель, если уже существуют крупные готовые решения? Но на промышленном уровне появляются другие факторы.
Почему выбор не очевиден
- Зависимость от внешнего поставщика
- Изменение лицензирования
- Ограничения доступа
- Стоимость inference
- Требования к безопасности данных
- Необходимость глубокой специализации модели
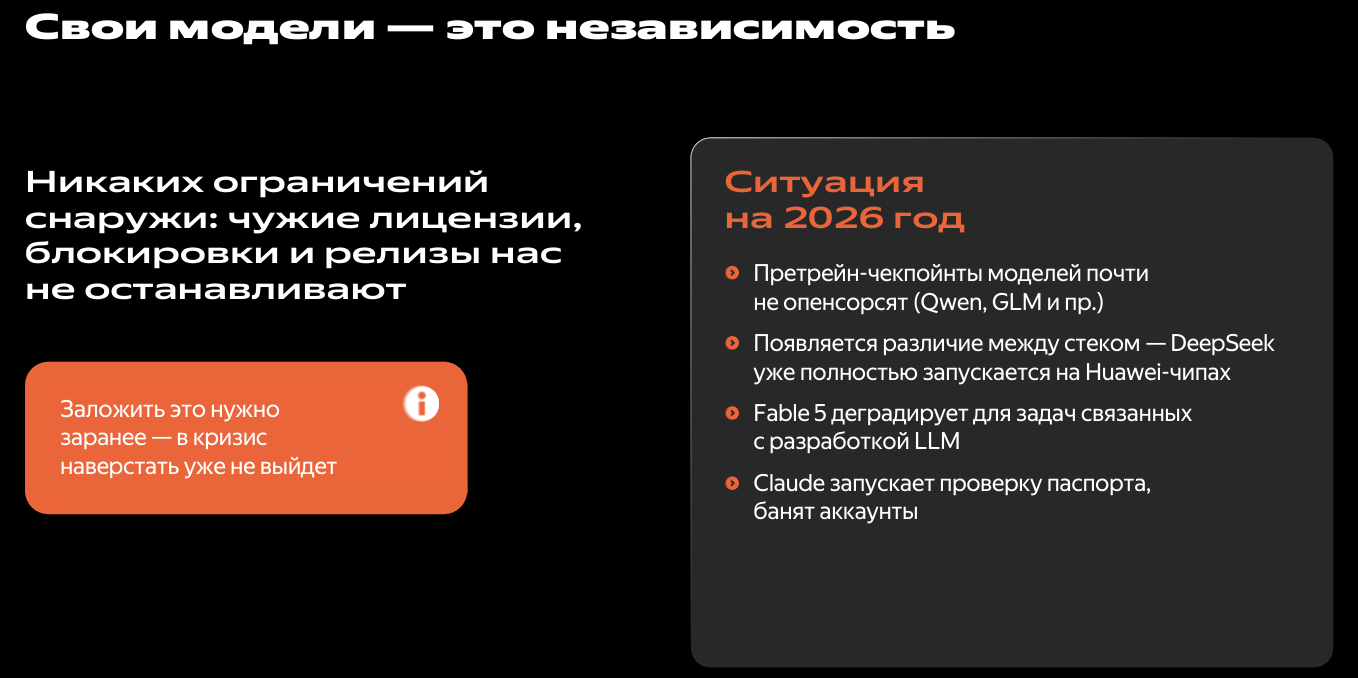
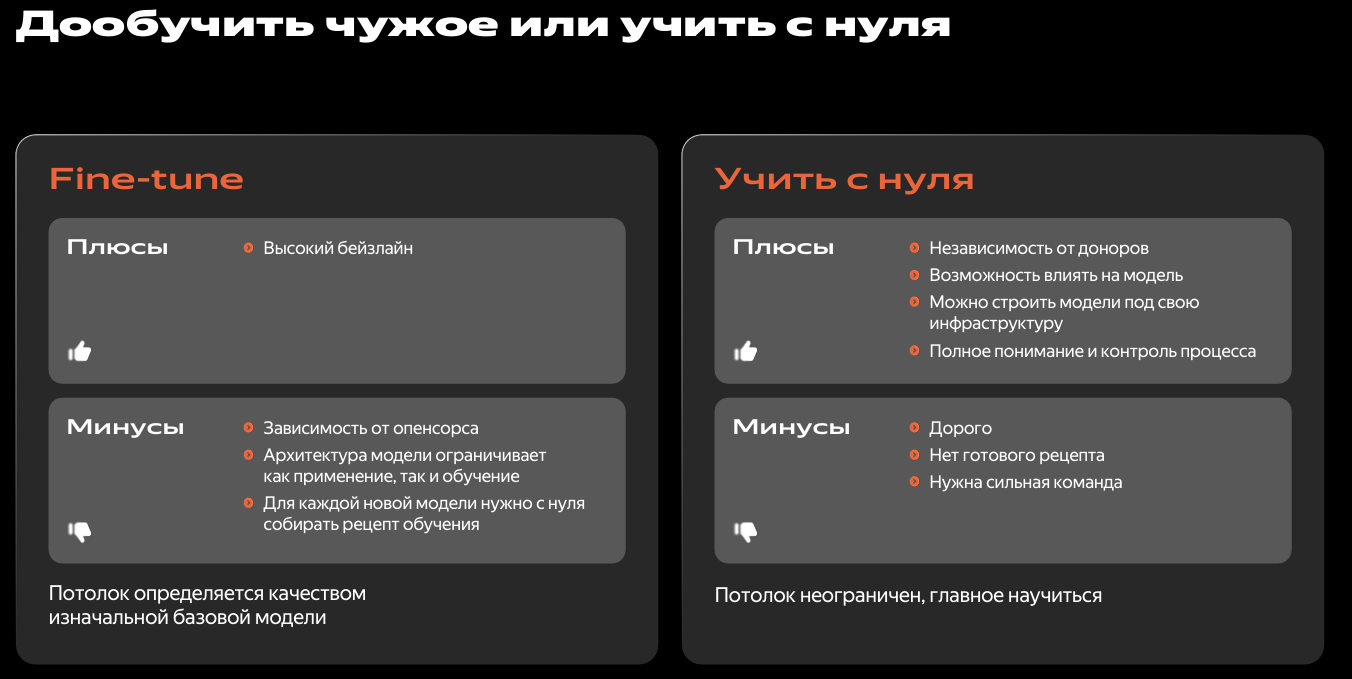
Поэтому выбор оказывается значительно сложнее. Можно использовать готовую модель. Можно выполнить fine-tuning и адаптировать её под собственные задачи. А можно строить модель практически с нуля, получая значительно большую независимость и контроль — ценой огромных вычислительных ресурсов, данных и сильной инженерной команды.
Универсального ответа здесь нет. Но разработчику важно понимать, что за кнопкой «подключить AI» находится огромный технологический стек.
Physical AI: когда цена ошибки выходит за пределы экрана
Особенно интересно увидеть, что AI развивается не только внутри браузеров, IDE и корпоративных сервисов. В выступлении Сергея Мельника речь шла о Physical AI — системах, которые взаимодействуют уже не с текстом на экране, а с физическим миром.
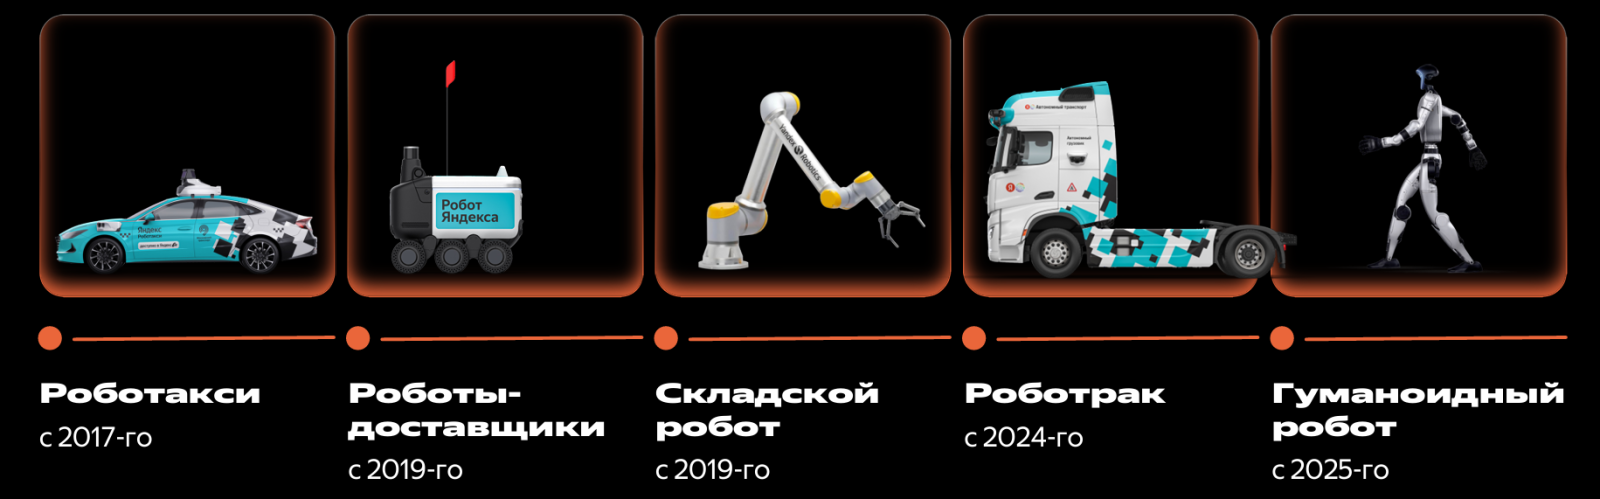
Роботакси, роботы-доставщики, складская робототехника, роботраки, гуманоидные системы — здесь требования к AI становятся совершенно другими. Ошибка чат-бота может привести к неправильному ответу. Ошибка автономного автомобиля способна привести к совершенно другим последствиям.
Поэтому одной LLM здесь недостаточно. Необходимы системы восприятия окружающего мира, прогнозирования поведения объектов, построения траектории, моделирования различных сценариев и независимый safety-контур.
Особое значение приобретает симуляция. Некоторые опасные ситуации возникают настолько редко, что собрать достаточное количество примеров в реальном мире практически невозможно. Поэтому их приходится воспроизводить виртуально и проверять реакцию системы тысячи и миллионы раз.
Чем выше автономность AI, тем серьёзнее должны быть механизмы контроля.
Что всё это означает для разработчиков
Пожалуй, главный вопрос для нас как учебного центра — не просто «что нового показали на конференции?». Гораздо важнее другое: каким должен быть разработчик в ближайшие годы?
Очевидно, что одного умения писать код становится недостаточно. Современному специалисту необходимо понимать весь жизненный цикл продукта. Уметь работать с AI-инструментами, но не доверять им вслепую. Проверять сгенерированный код. Понимать архитектуру агентов. Проектировать права доступа. Работать с контекстом и данными. Продумывать тестирование. Строить наблюдаемость. Понимать эксплуатацию системы.
И, пожалуй, самое важное — задавать вопрос: зачем здесь вообще нужен AI? Не потому, что это модно. Не потому, что «все уже внедряют». А потому, что технология должна давать конкретный измеримый результат.
Как это повлияет на обучение в «ТЕРАКОР»
Мы не собираемся превращать каждую программу в курс с приставкой «AI». Java остаётся Java. Spring — Spring. PostgreSQL — PostgreSQL. Kafka — Kafka. Микросервисная архитектура по-прежнему требует понимания распределённых систем, данных, API, отказоустойчивости и эксплуатации.
Но теперь поверх классической инженерии появляется новый слой. Разработчик должен понимать, как AI становится частью реального программного продукта.
Поэтому соответствующие подходы постепенно будут интегрироваться в программы «ТЕРАКОР»: вместе с Java, Spring, микросервисами, базами данных, API, тестированием и разработкой полноценных проектов. Не как отдельная модная глава в конце курса. А как ещё один инструмент современной инженерии.
Разрабатывать. Применять. Обучать
Yandex Deep Tech Night ещё раз подтвердила то, на чём строится подход «ТЕРАКОР». Между знанием технологии и умением использовать её в реальном проекте — огромная разница.
Можно посмотреть десятки видео об AI-агентах. Можно прочитать документацию. Можно установить AI-ассистента. Но настоящее понимание появляется тогда, когда технология сталкивается с реальным приложением, реальными данными, ограничениями, ошибками, безопасностью и ответственностью за результат. И только после этого появляется опыт, который действительно имеет смысл передавать студентам.
Благодарим Яндекс за приглашение на Yandex Deep Tech Night и сильную программу конференции. Отдельно хочется отметить Александра Куваева за необычный интерактивный формат, благодаря которому аудитория не просто слушала рассказ об AI-driven-разработке, а фактически сама моделировала внедрение искусственного интеллекта на разных этапах создания продукта.
Для нас такие мероприятия — возможность сверить собственное понимание развития отрасли с тем, что происходит внутри крупнейших технологических команд.
Разрабатывать самим → применять технологии на практике → понимать их сильные и слабые стороны → и только затем обучать других.
Готовы учиться у практикующих разработчиков? Программы «ТЕРАКОР» строятся на реальной инженерии — от Java и Spring до микросервисов, баз данных и проектов в портфолио.