Введение: Эволюция распределенных систем к 2026 году
В мире современной разработки программного обеспечения распределенные системы стали стандартом де-факто для построения масштабируемых, отказоустойчивых и высоконагруженных приложений. Если еще несколько лет назад многие компании только начинали свой путь от монолита к микросервисам, то сегодня микросервисная архитектура является фундаментом для enterprise-решений. В центре этой архитектурной революции находятся брокеры сообщений, и безусловным лидером в этой области остается Apache Kafka.
С наступлением 2026 года мы видим, как apache kafka 2026 эволюционировала из простого инструмента для передачи логов в полноценную платформу потоковой передачи событий (Event Streaming Platform). Отказ от ZooKeeper в пользу KRaft, внедрение Tiered Storage и развитие экосистемы Kafka Streams сделали эту технологию незаменимой для реализации паттернов event-driven архитектуры. В этой статье мы проведем глубокое техническое погружение во внутреннее устройство Kafka, рассмотрим современные архитектурные паттерны и приведем примеры интеграции на Java и Python.
Внутренняя архитектура Apache Kafka: Под капотом
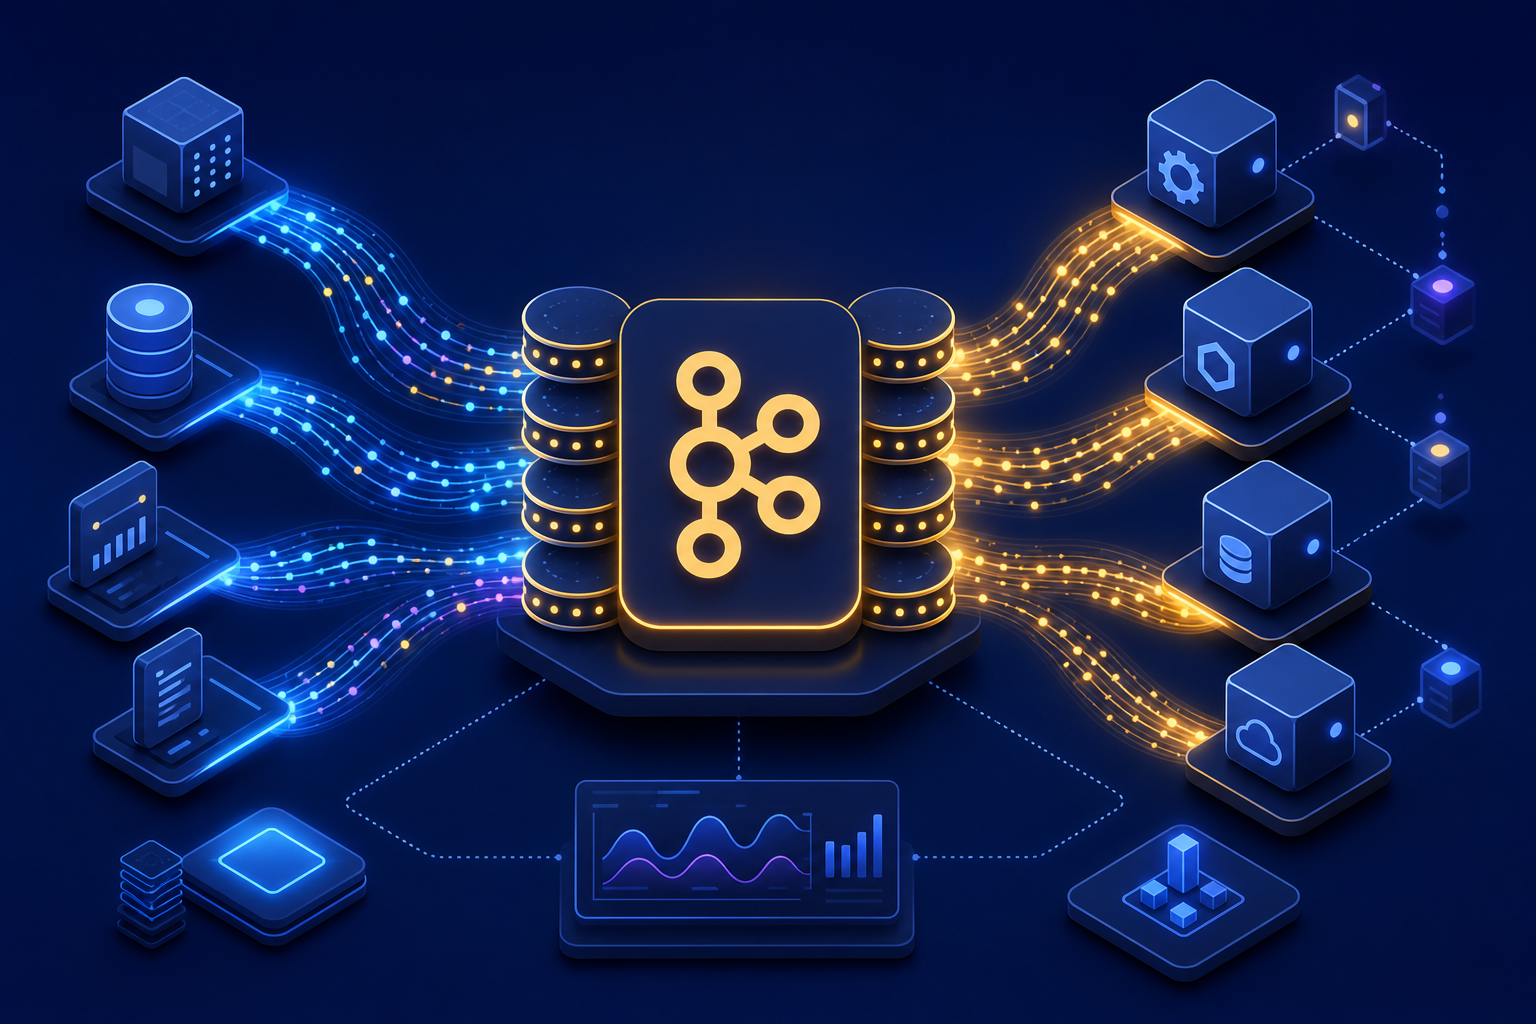
Чтобы эффективно использовать Kafka, необходимо понимать ее внутреннее устройство. В отличие от традиционных очередей сообщений (например, RabbitMQ), Kafka работает как распределенный журнал фиксации событий (distributed commit log). Данные записываются последовательно и сохраняются на диске, что обеспечивает высокую пропускную способность и надежность.
Топики, Партиции и Репликация
Логическое разделение данных в Kafka происходит через топики (Topics). Каждый топик разбивается на партиции (Partitions), которые являются базовой единицей масштабирования. Партиции распределяются между различными брокерами в кластере. Когда продюсер (Producer) отправляет сообщение, оно попадает в определенную партицию (на основе ключа сообщения или алгоритма Round-Robin) и получает уникальный последовательный номер — смещение (Offset).
Отказоустойчивость достигается за счет механизма репликации. Каждая партиция имеет одну Leader-реплику и несколько Follower-реплик. Все операции записи и чтения по умолчанию идут через Leader-реплику, в то время как Follower-реплики асинхронно копируют данные. В 2026 году механизмы репликации стали еще более оптимизированными благодаря улучшениям в протоколе KRaft.
Zero-Copy и Page Cache
Секрет невероятной производительности Kafka кроется в активном использовании системного кэша страниц (Page Cache) и механизма Zero-Copy. Вместо того чтобы загружать данные в память приложения (JVM heap), Kafka делегирует управление кэшированием операционной системе. При чтении данных консьюмером (Consumer) Kafka использует системный вызов sendfile(), который позволяет передавать данные напрямую из Page Cache в сетевой сокет, минуя пространство пользователя. Это кардинально снижает нагрузку на CPU и потребление памяти.
Отказ от ZooKeeper и эпоха KRaft
Одним из самых значимых событий в экосистеме Kafka стал полный отказ от Apache ZooKeeper. В 2026 году архитектура KRaft (Kafka Raft) является единственным поддерживаемым режимом работы. Ранее ZooKeeper использовался для хранения метаданных кластера, управления выборами контроллера и хранения ACL.
Проблема заключалась в том, что ZooKeeper был отдельной распределенной системой со своими правилами настройки, мониторинга и безопасности. Это усложняло администрирование и создавало узкие места при масштабировании кластера до миллионов партиций. KRaft интегрирует консенсусный протокол Raft непосредственно в брокеры Kafka. Теперь метаданные хранятся в специальном внутреннем топике __cluster_metadata, а контроллер выбирается из числа самих брокеров (или выделенных узлов-контроллеров).
Преимущества KRaft в 2026 году очевидны: мгновенное восстановление после сбоев (выборы нового лидера занимают миллисекунды), поддержка кластеров с десятками миллионов партиций и упрощенная архитектура развертывания, что особенно важно для Kubernetes-сред.
Паттерны Event-Driven Architecture (EDA)
Микросервисная архитектура требует новых подходов к управлению состоянием и взаимодействию между сервисами. Синхронные вызовы по REST/gRPC создают сильную связность (tight coupling) и снижают общую отказоустойчивость системы. Переход к event-driven архитектуре решает эти проблемы.
Event Sourcing (Источник событий)
Паттерн Event Sourcing предполагает хранение не текущего состояния объекта, а последовательности событий, которые привели к этому состоянию. Kafka идеально подходит для роли Event Store благодаря своей способности хранить данные вечно (при правильной настройке retention) и гарантировать строгий порядок событий в рамках партиции.
Например, в банковской системе вместо обновления баланса счета в базе данных, мы записываем события: AccountCreated, MoneyDeposited, MoneyWithdrawn. Текущий баланс вычисляется путем проекции (свертки) всех этих событий. Если происходит сбой, мы всегда можем восстановить состояние системы, перечитав топик с самого начала.
CQRS (Command Query Responsibility Segregation)
CQRS часто используется в связке с Event Sourcing. Этот паттерн разделяет модели чтения (Query) и записи (Command). Команды генерируют события, которые публикуются в Kafka. Различные микросервисы-проекторы подписываются на эти события и формируют оптимизированные представления (Read Models) в базах данных, таких как Elasticsearch, Redis или PostgreSQL, специально заточенных под конкретные запросы.
Кейс из 2026 года: Глобальная платформа электронной коммерции
Рассмотрим реальный пример использования Event-Driven Architecture в 2026 году на базе крупной e-commerce платформы. При оформлении заказа монолитная система ранее выполняла синхронные вызовы к сервисам склада, оплаты, логистики и уведомлений. Сбой в сервисе уведомлений мог привести к отказу всего процесса оформления заказа (Cascading Failure).
Переход на Kafka кардинально изменил архитектуру. Теперь сервис заказов (Order Service) просто публикует событие OrderPlaced в топик Kafka. Сервис оплаты (Payment Service) подписывается на этот топик, обрабатывает платеж и публикует событие PaymentProcessed. Сервис склада (Inventory Service) реагирует на успешный платеж, резервирует товар и публикует InventoryReserved. Эта хореография микросервисов (Choreography) делает систему невероятно устойчивой. Если сервис логистики временно недоступен, он просто накопит Consumer Lag и обработает все события доставки, как только восстановит работу. Ни один заказ не будет потерян, а пользователи не заметят сбоев в работе ядра системы.
Интеграция Kafka с микросервисами на Java (Spring Boot 3.x)
Java остается доминирующим языком в enterprise-сегменте, и интеграция Kafka со Spring Boot в 2026 году достигла невероятного уровня удобства. Если вы планируете обучение kafka, то связка Java + Spring Boot — это то, с чего стоит начать. Многие курсы java kafka фокусируются именно на этом стеке.
Рассмотрим пример настройки Producer и Consumer с использованием современных фич Spring Kafka, таких как неблокирующие повторные попытки (Non-blocking Retries) и Dead Letter Queues (DLQ).
Пример Producer на Java
@Configuration
public class KafkaProducerConfig {
    @Bean
    public KafkaTemplate<String, OrderEvent> kafkaTemplate(ProducerFactory<String, OrderEvent> producerFactory) {
        return new KafkaTemplate<>(producerFactory);
    }
}

@Service
@RequiredArgsConstructor
public class OrderPublisher {
    private final KafkaTemplate<String, OrderEvent> kafkaTemplate;
    private static final String TOPIC = "orders-events";

    public void publishOrderCreated(OrderEvent event) {
        CompletableFuture<SendResult<String, OrderEvent>> future =
            kafkaTemplate.send(TOPIC, event.getOrderId(), event);

        future.whenComplete((result, ex) -> {
            if (ex == null) {
                System.out.println("Message sent successfully to partition " +
                    result.getRecordMetadata().partition());
            } else {
                System.err.println("Failed to send message: " + ex.getMessage());
            }
        });
    }
}
Пример Consumer с поддержкой DLQ
@Service
public class OrderEventListener {

    @RetryableTopic(
        attempts = "3",
        backoff = @Backoff(delay = 1000, multiplier = 2.0),
        autoCreateTopics = "false",
        dltStrategy = DltStrategy.FAIL_ON_ERROR
    )
    @KafkaListener(topics = "orders-events", groupId = "inventory-service-group")
    public void handleOrderEvent(@Payload OrderEvent event,
                                 @Header(KafkaHeaders.RECEIVED_PARTITION) int partition) {
        System.out.println("Processing event from partition " + partition + ": " + event);
        // Бизнес-логика обновления остатков
        if (event.getAmount() < 0) {
            throw new IllegalArgumentException("Invalid order amount");
        }
    }

    @DltHandler
    public void handleDlt(OrderEvent event, @Header(KafkaHeaders.EXCEPTION_MESSAGE) String error) {
        System.err.println("Message sent to DLT: " + event + " due to error: " + error);
        // Сохранение в базу данных для ручного разбора
    }
}
Интеграция Kafka с Python (FastAPI & aiokafka)
В сфере Data Science, машинного обучения и быстрых микросервисов Python занимает лидирующие позиции. В 2026 году стандартом для создания асинхронных API на Python является FastAPI. Для работы с Kafka в асинхронном режиме отлично подходит библиотека aiokafka.
Ниже представлен пример интеграции FastAPI приложения с Kafka для потоковой обработки данных в реальном времени.
from fastapi import FastAPI, BackgroundTasks
from aiokafka import AIOKafkaProducer, AIOKafkaConsumer
import asyncio
import json

app = FastAPI(title="Kafka Python Microservice 2026")
producer = None

@app.on_event("startup")
async def startup_event():
    global producer
    producer = AIOKafkaProducer(
        bootstrap_servers='localhost:9092',
        value_serializer=lambda v: json.dumps(v).encode('utf-8')
    )
    await producer.start()
    asyncio.create_task(consume_messages())

@app.on_event("shutdown")
async def shutdown_event():
    await producer.stop()

async def consume_messages():
    consumer = AIOKafkaConsumer(
        'analytics-events',
        bootstrap_servers='localhost:9092',
        group_id="python-analytics-group",
        value_deserializer=lambda m: json.loads(m.decode('utf-8'))
    )
    await consumer.start()
    try:
        async for msg in consumer:
            print(f"Consumed: {msg.topic} partition: {msg.partition} offset: {msg.offset} key: {msg.key} value: {msg.value}")
            # Асинхронная обработка данных
    finally:
        await consumer.stop()

@app.post("/events/")
async def send_event(event_data: dict):
    # Отправка сообщения в Kafka
    await producer.send_and_wait("analytics-events", event_data)
    return {"status": "Event queued successfully"}
Kafka Streams и ksqlDB: Потоковая обработка данных в реальном времени
Брокеры сообщений сами по себе лишь передают данные. Настоящая магия начинается при использовании инструментов потоковой обработки. Kafka Streams — это легковесная клиентская библиотека для Java/Scala, позволяющая строить сложные топологии обработки данных (фильтрация, маппинг, агрегация, джойны) прямо внутри вашего микросервиса, без необходимости разворачивать отдельные кластеры Apache Flink или Spark.
В 2026 году Kafka Streams предлагает улучшенную поддержку Exactly-Once Semantics (EOS) версии 2, которая минимизирует накладные расходы на транзакции. Вы можете легко выполнять Stateful-операции, такие как оконные агрегации (Windowing), сохраняя промежуточное состояние в локальных RocksDB хранилищах, которые автоматически бэкапятся в специальные changelog-топики Kafka.
Для тех, кто предпочитает SQL, существует ksqlDB — потоковая база данных, построенная поверх Kafka Streams. Она позволяет писать SQL-запросы, которые выполняются непрерывно над потоками данных. Например, можно легко создать материализованное представление (Materialized View), которое в реальном времени считает количество активных пользователей на сайте, и обращаться к нему по REST API.
Tiered Storage и бесконечное хранение данных в Kafka
Одной из главных архитектурных проблем Kafka в прошлом была тесная связь между вычислительными ресурсами (брокерами) и хранилищем данных. Если вам нужно было хранить петабайты исторических данных, приходилось добавлять новые брокеры с большими дисками, что делало кластер дорогим и сложным в перебалансировке.
В 2026 году технология Tiered Storage (многоуровневое хранение) стала стандартом. Tiered Storage позволяет Kafka выгружать старые сегменты логов в дешевые объектные хранилища (Amazon S3, Google Cloud Storage, MinIO), оставляя на локальных NVMe-дисках брокеров только самые свежие данные. Это архитектурное решение превращает Kafka в безграничное озеро данных (Data Lake). Теперь концепция Event Sourcing с вечным хранением событий стала экономически оправданной и легко реализуемой на практике.
Экосистема Kafka: Schema Registry и Kafka Connect
Работая с Kafka в масштабах крупной компании, вы неизбежно столкнетесь с проблемой эволюции схем данных. Когда десятки различных микросервисов обмениваются событиями, изменение структуры JSON-сообщения (например, удаление поля или изменение его типа) может привести к массовым сбоям в работе консьюмеров. Для решения этой проблемы в 2026 году повсеместно используется Schema Registry.
Schema Registry выступает в роли единого источника истины для форматов сообщений. Вместо того чтобы передавать сырой JSON, системы используют бинарные форматы сериализации, такие как Apache Avro, Protocol Buffers (Protobuf) или JSON Schema. Продюсер перед отправкой сообщения валидирует его схему через реестр. Если схема обратно несовместима (Backward Incompatible), отправка блокируется еще на этапе разработки. В само сообщение в Kafka записывается только идентификатор схемы и компактные бинарные данные, что дополнительно экономит сетевой трафик и место на диске.
Еще один важнейший компонент экосистемы — Kafka Connect. Это фреймворк для потоковой интеграции Kafka с внешними системами хранения данных без написания пользовательского кода. Kafka Connect работает на базе коннекторов (Source и Sink). Например, Debezium Source Connector позволяет реализовать паттерн Change Data Capture (CDC): он читает транзакционный лог базы данных (например, WAL в PostgreSQL) и транслирует каждое изменение строки в виде события в топик Kafka. Затем Sink Connector может автоматически выгружать эти события в хранилище аналитики, такое как ClickHouse или Snowflake. В 2026 году Kafka Connect поддерживает сотни готовых коннекторов для любых мыслимых систем, превращая Kafka в универсальный интеграционный хаб.
Безопасность Kafka в 2026 году: Аутентификация и Авторизация
По мере того как Kafka становится центральным хабом для всех корпоративных данных, вопросы безопасности выходят на первый план. В 2026 году стандартная установка Kafka требует строгой настройки аутентификации и авторизации.
Шифрование трафика (TLS)
Все коммуникации между брокерами, а также между клиентами и кластером должны быть зашифрованы с использованием TLS 1.3. Это предотвращает перехват данных (Man-in-the-Middle) в распределенных сетях. Настройка TLS требует генерации сертификатов для каждого узла и настройки Keystore/Truststore.
Аутентификация (SASL/SCRAM и OAuth 2.0)
Для аутентификации клиентов в 2026 году наиболее популярными механизмами являются SASL/SCRAM (Salted Challenge Response Authentication Mechanism) и интеграция с провайдерами идентификации через OAuth 2.0 (OIDC). Использование OAuth 2.0 позволяет микросервисам получать короткоживущие JWT-токены от сервера авторизации (например, Keycloak) и использовать их для подключения к Kafka, что избавляет от необходимости хранить статические пароли в конфигурационных файлах.
Авторизация (ACL и RBAC)
После успешной аутентификации Kafka должна проверить, имеет ли клиент права на выполнение определенного действия (например, чтение из топика financial-transactions). Встроенный механизм ACL (Access Control Lists) позволяет детально настроить права на уровне топиков, групп консьюмеров и кластера. В крупных enterprise-решениях (таких как Confluent Platform) также активно применяется RBAC (Role-Based Access Control), позволяющий назначать роли (например, DeveloperRead, ResourceOwner) на уровне целых пространств имен.
Лучшие практики и антипаттерны при работе с Kafka в 2026 году
Несмотря на всю мощь Kafka, неправильное использование может привести к катастрофическим последствиям для распределенных систем. Рассмотрим ключевые лучшие практики:
Лучшие практики и антипаттерны при работе с Kafka в 2026 году
- Идемпотентность консьюмеров: Kafka гарантирует доставку At-Least-Once (хотя бы один раз) по умолчанию. В случае сетевых сбоев или ребалансировок консьюмер может получить одно и то же сообщение дважды. Ваш код должен быть идемпотентным (безопасным к повторному выполнению). Используйте уникальные идентификаторы сообщений (например, UUID) и проверяйте их наличие в базе данных перед обработкой.
- Правильный выбор ключа партиционирования: Ключ сообщения определяет, в какую партицию оно попадет. Сообщения с одинаковым ключом всегда попадают в одну партицию, что гарантирует строгий порядок их обработки. Неудачный выбор ключа (например, ключ, который часто повторяется) приведет к "горячим партициям" (Data Skew) и неравномерной нагрузке на брокеры.
- Настройка Acks = "all": Для критически важных данных продюсер должен использовать настройку
acks="all". Это означает, что лидер партиции дождется подтверждения записи от всех синхронных реплик (In-Sync Replicas, ISR) перед тем, как вернуть успешный ответ продюсеру. В сочетании сmin.insync.replicas > 1это исключает потерю данных при падении брокера. - Мониторинг Consumer Lag: Самая важная метрика для мониторинга — это отставание консьюмера (Consumer Lag). Если это значение постоянно растет, значит ваш микросервис не справляется с потоком входящих данных. Решение — оптимизация кода обработки или добавление новых экземпляров сервиса (до тех пор, пока количество консьюмеров не превысит количество партиций).
- Транзакционность (Exactly-Once Semantics): Если ваш микросервис читает данные из одного топика, обрабатывает их и записывает результат в другой топик, используйте транзакции Kafka. Транзакционный API гарантирует, что чтение смещения и запись нового сообщения произойдут атомарно. В случае ошибки транзакция откатится, и данные не будут задублированы. В Spring Boot это настраивается добавлением аннотации
@Transactionalна метод слушателя и конфигурациейtransactionIdPrefixв продюсере. - Сжатие данных (Compression): Всегда включайте сжатие на уровне продюсера (например, алгоритмы LZ4 или ZSTD). Kafka хранит и передает сообщения в сжатом виде, распаковывая их только на стороне консьюмера. Это позволяет увеличить пропускную способность сети в несколько раз и значительно сократить затраты на хранение данных (особенно при использовании Tiered Storage).
- Изоляция кластеров и Multi-Region развертывание: Для обеспечения катастрофоустойчивости (Disaster Recovery) крупные системы в 2026 году используют геораспределенные кластеры Kafka. Инструменты вроде MirrorMaker 2 или Confluent Cluster Linking позволяют асинхронно реплицировать топики между дата-центрами в разных частях света, обеспечивая RPO (Recovery Point Objective) близкий к нулю.
Обучение и развитие: Как освоить Kafka
Спрос на специалистов, умеющих проектировать отказоустойчивые системы на базе Kafka, продолжает расти. Качественное обучение kafka требует не только теоретических знаний, но и глубокой практики. Рекомендуется начинать с изучения базовых концепций распределенных систем, понимания CAP-теоремы и принципов Event-Driven архитектуры.
Для Java-разработчиков существуют специализированные курсы java kafka, которые покрывают интеграцию со Spring Boot, настройку транзакционности, работу с Kafka Streams и паттерны тестирования (например, с использованием Testcontainers). Важно также изучить инструменты экосистемы, такие как Schema Registry (для управления схемами Avro/Protobuf/JSON) и Kafka Connect (для интеграции с внешними базами данных без написания кода).
Заключение
В 2026 году Apache Kafka — это не просто шина данных, это центральная нервная система любой современной enterprise-архитектуры. Переход на KRaft, внедрение Tiered Storage и развитие экосистемы сделали Kafka более надежной, масштабируемой и простой в управлении. Понимание внутренних механизмов работы брокеров сообщений и грамотное применение паттернов Event-Driven Architecture позволяет разработчикам создавать системы, способные выдерживать колоссальные нагрузки и легко адаптироваться к изменяющимся требованиям бизнеса. Инвестиции в изучение Kafka сегодня — это гарантия востребованности и профессионального роста в мире высоконагруженных распределенных систем.